PDF Seiten extrahieren
Hole nur die Seiten, die du brauchst, aus einem größeren PDF heraus und speichere sie als neues, eigenständiges Dokument. Praktisch, wenn du nur den relevanten Teil einer Datei weitergeben willst. Auswahl und Extraktion passieren vollständig in deinem Browser.
Deine Datei verlässt dein Gerät nicht. Sie wird nicht auf einen Server kopiert, nicht zwischengespeichert und nicht nach einer Stunde gelöscht. Jedes Tool auf dieser Seite arbeitet mit JavaScript direkt in dem Tab, den du gerade offen hast.
Datei hierher ziehen oder zum Auswählen klicken
PDF Seiten extrahieren: Schritt für Schritt
 1
PDF auswählen
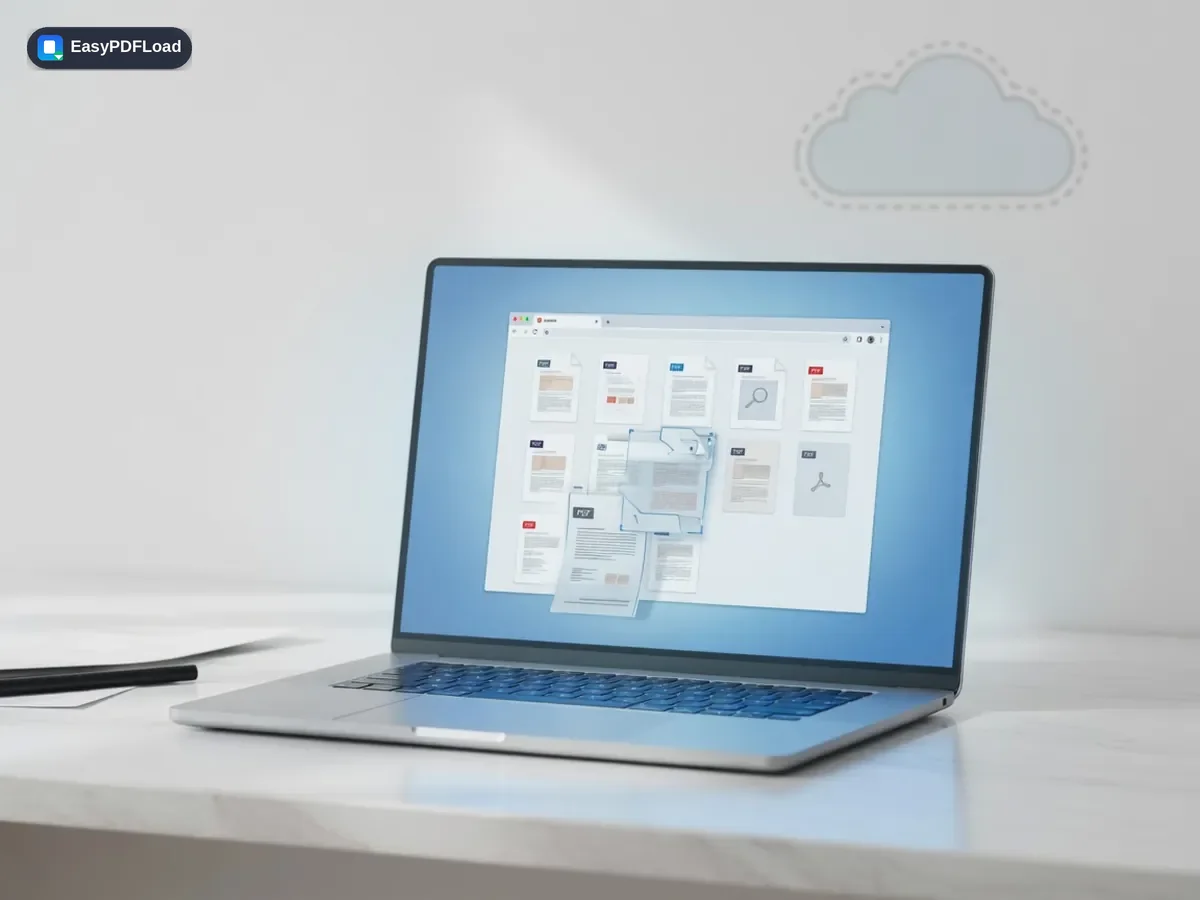
Ziehe ein PDF in das Feld. Sobald die Vorschau fertig gerendert ist, erscheint ein Raster mit Seitenvorschauen, bis dahin bleibt der Button zum Extrahieren deaktiviert.
 2
Seiten auswählen
Klicke jede Seite an, die du behalten willst. Ausgewählte Vorschaubilder bekommen einen blauen Rand und den Hinweis „Behalten“, ein Zähler zeigt die Anzahl. Ein weiterer Klick hebt die Auswahl auf.
- 3
Extrahieren
Klicke auf den Button, der zum Beispiel „3 Seiten extrahieren“ heißt. Ist nichts ausgewählt, wirst du aufgefordert, mindestens eine Seite zu wählen.
 4
Herunterladen
Dein Browser speichert eine neue Datei, benannt nach dem Original mit dem Zusatz „-extracted“, zum Beispiel vertrag-extracted.pdf. Die Originaldatei wird nie verändert.
Ein Beispiel aus der Praxis
Eine Mieterin hat einen 60-seitigen gescannten Mietvertrag, und die Hausverwaltung möchte nur die Unterschriftsseite und den Nachtrag zur Tierhaltung. Sie öffnet die Datei, klickt diese beiden Vorschaubilder an und lädt ein zweiseitiges PDF herunter, statt eine große Datei zu mailen, die auf anderen Seiten auch Bankdaten enthält.
Warum PDF Seiten extrahieren direkt im Browser?
- Schicke nur die eine unterschriebene Seite oder ein Kapitel, ohne das ganze Dokument mit allem, was sonst darin steht, weiterzuleiten.
- Die Vorschaubilder zeigen den echten Seiteninhalt, du wählst also danach, wie eine Seite aussieht, und musst Seitenzahlen nicht raten.
- Das Quell-PDF wird in deinem Browser-Tab gelesen, für ein paar Seiten musst du die ganze Datei nicht hochladen.
- Seiten werden unverändert kopiert, Text bleibt markierbar und Bilder werden nicht neu komprimiert.
Was sich an deiner Datei ändert
Die Datei wird mit der File-API des Browsers gelesen und in diesem Tab in pdf-lib geladen. Ein leeres zweites Dokument wird angelegt, die gewählten Seiten werden als ganze Seitenobjekte hineinkopiert, und das Ergebnis wird im Arbeitsspeicher gespeichert und an deinen Download übergeben. Die Vorschaubilder zeichnet pdf.js auf Canvas-Elemente im selben Tab. Zur Kontrolle öffnest du den Tab „Netzwerk“, bevor du eine Datei hineinziehst: Keine Anfrage überträgt das Dokument.
Grenzen und Sonderfälle
- Die Seiten kommen immer in ihrer ursprünglichen Reihenfolge heraus. Klickst du Seite 9 vor Seite 3, steht in der neuen Datei trotzdem Seite 3 zuerst. Nutze danach „PDF Seiten sortieren“, wenn du eine andere Reihenfolge brauchst.
- Es gibt kein Feld für Seitenbereiche und keine Schaltfläche „Alle auswählen“. Jede Seite wird per Klick auf ihr Vorschaubild gewählt.
- Die Vorschaubilder des ganzen Dokuments werden erzeugt, bevor du extrahieren kannst. Eine große Datei braucht daher spürbar Zeit und Arbeitsspeicher im Tab.
- Verschlüsselte oder beschädigte Dateien lassen sich nicht lesen, die Seite zeigt dann eine Fehlermeldung.
- Jede extrahierte Seite behält ihre eigene Größe und Ausrichtung. Nichts wird skaliert, beschnitten oder neu nummeriert.
- Es lässt sich immer nur ein PDF laden. Willst du Seiten aus mehreren Dateien vereinen, extrahiere aus jeder und nutze dann „PDF zusammenfügen“.
Ein Beispiel zum Nachvollziehen: PDF Seiten extrahieren, Klicks und Ergebnis
Angenommen, du öffnest einen Bericht mit 12 Seiten und klickst nacheinander die Seiten 9, 3 und 4 an. Der Zähler zeigt „3 Seiten zum Behalten ausgewählt“, und die Schaltfläche heißt „3 Seiten extrahieren“. So sieht der Download aus.
- Seite 3 des Berichts wird Seite 1 der neuen Datei.
- Seite 4 wird Seite 2.
- Seite 9 wird Seite 3.
Die Klicks wurden nach ursprünglicher Position sortiert, die Klickreihenfolge spielt also nie eine Rolle. Die anderen neun Seiten werden einfach nicht kopiert, und der Bericht selbst bleibt unverändert.
- Soll Seite 9 zuerst kommen? Öffne das Ergebnis in PDF Seiten sortieren und ziehe sie nach vorn.
- Behältst du das meiste vom Dokument und willst nur ein paar Seiten loswerden? Die Seiten zum Verwerfen in PDF Seiten löschen auszuwählen geht schneller, als hier alle übrigen anzuklicken.
- Soll jedes Kapitel eine eigene Datei werden? Das ist ein Fall für PDF teilen, nicht für wiederholtes Extrahieren.